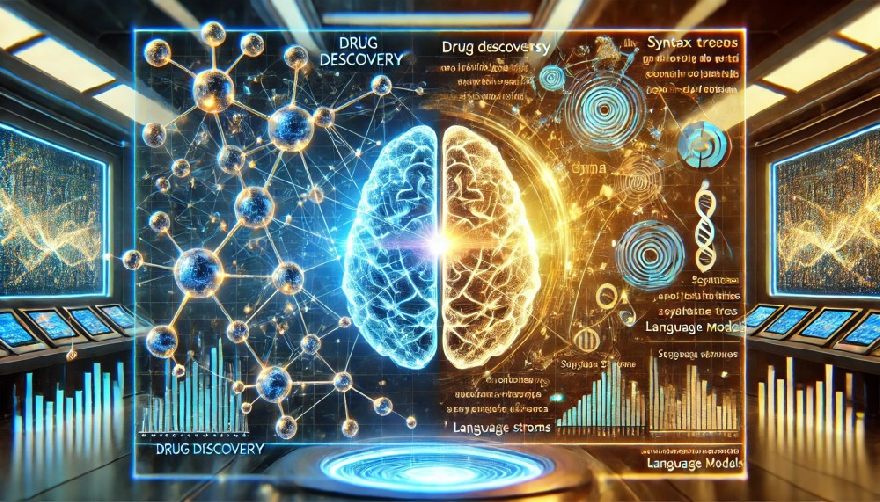
יישום טכניקות בינה מלאכותית מגילוי תרופות ועד לתואר שני במשפטים להפחתת הזיות
5 בדצמבר, 2024
פרויקטים מהפכניים ב-GitHub: גילוי תרופות אוטומטי בעזרת בינה מלאכותית
שילוב הבינה המלאכותית (AI) בגילוי תרופות מחולל מהפכה בתעשיית התרופות. פרויקטים בקוד פתוח ב-GitHub ממלאים תפקיד מכריע בכך. להלן, אנו מציגים כמה מהפרויקטים החדשניים ביותר המקדמים גילוי תרופות אוטומטי באמצעות בינה מלאכותית.
DeepChem: פלטפורמה פתוחה ללמידה עמוקה בכימיה
DeepChem היא ספריית קוד פתוח מובילה שהופכת למידה עמוקה לנגישה ליישומים כימיים. הוא מספק כלים עבור:
- מידול מולקולרי
- ניבוי מבנה חלבון
- מדעי החומרים
באמצעות ממשק ידידותי למשתמש, DeepChem מאפשר לחוקרים ליישם מודלים מורכבים של בינה מלאכותית ללא ידע מעמיק בתכנות. זה מאיץ את גילוי תרופות חדשות ומקדם חדשנות בתעשייה.
MoleculeNet: בדיקת מידות לבינה מלאכותית בכימיה
MoleculeNet היא מערכת מקיפה לבדיקת מידות שתוכננה במיוחד ללמידת מכונה במחקר כימי. הוא מציע:
- מערכי נתונים סטנדרטיים
- מדדי הערכה
- השוואת ביצועי מודלים
על ידי מתן מדדי ביצועים עקביים, MoleculeNet מאפשרת השוואה בין מודלים שונים של בינה מלאכותית, ובכך מקדמת התקדמות בגילוי תרופות.
ATOM Modeling PipeLine (AMPL): גילוי תרופות מואץ
ATOM Modeling PipeLine הוא פרויקט של קונסורציום ATOM שמטרתו להאיץ את פיתוח התרופות באמצעות למידת מכונה. AMPL מציעה:
- צינור מודולרי להכנת נתונים
- אימון מודלים אוטומטי
- מסגרות ניתנות להרחבה עבור מקרי שימוש שונים
בעזרת AMPL, חוקרים יכולים לבנות ביעילות מודלים מורכבים, ובכך לקצר את הזמן מגילוי ועד שיווק של תרופות חדשות.
Chemprop: חיזוי תכונות מולקולריות עם למידה עמוקה
Chemprop משתמש ברשתות עצביות גרפיות כדי לחזות תכונות מולקולריות. התכונות שלו כוללות:
- דיוק חיזוי גבוה
- ארכיטקטורות מודל ניתנות להתאמה
- תמיכה במערכי נתונים כימיים מגוונים
Chemprop השיגה תוצאות יוצאות דופן במספר תחרויות והיא כלי בעל ערך לכימיה בסיוע בינה מלאכותית.
DeepPurpose: ערכת כלים אוניברסלית לגילוי תרופות
DeepPurpose היא ערכת כלים מקיפה ללמידה עמוקה לגילוי תרופות. הוא מציע:
- שילוב של מודלים ומערכי נתונים שונים
- יישום קל של מודלים ניבוייים
- יישומים באינטראקציות חלבון-ליגנד
באמצעות הרבגוניות שלו, DeepPurpose מאפשר לחוקרים לזהות במהירות וביעילות מועמדים טיפוליים חדשים.
OpenChem: מסגרת למידה עמוקה ייעודית ליישומים כימיים
OpenChem היא מסגרת למידה עמוקה המותאמת לכימיה. הוא כולל:
- תמיכה ביצירת מולקולות
- ניבוי תכונות
- גמישות בתכנון מודלים
OpenChem מקדם פיתוח שיטות חדשות בבינה מלאכותית כימית ותורם להאצת המחקר.
קהילת הקוד הפתוח ב-GitHub דוחפת את גבולות גילוי תרופות אוטומטי עם פרויקטים אלה. שילוב של בינה מלאכותית וכימיה פותח אפשרויות חדשות לפיתוח פתרונות טיפוליים בצורה יעילה ומדויקת יותר. לחידושים אלה יש פוטנציאל לשנות את עתיד הרפואה באופן בר-קיימא.
יישום מודלים של מחקר בינה מלאכותית, החל מגילוי תרופות ועד זיקוק מודלים של בינה מלאכותית
ה-מודלים ושיטות הבינה המלאכותית בהם נעשה שימוש מציעים גישות חדשניות שניתן להעביר לזיקוק מודלים של בינה מלאכותית. למרות ששני התחומים נראים שונים במבט ראשון, הם חולקים טכניקות ואתגרים משותפים המאפשרים יישום משמעותי.
תחושת היישום
היישום של מודלים מחקריים מגילוי תרופות לזיקוק מודלים של בינה מלאכותית הגיוני מכיוון ש:
- שיטות נפוצות: שני התחומים משתמשים בטכניקות מתקדמות של למידת מכונה כגון למידה עמוקה, רשתות עצביות ומודלים מבוססי גרפים.
- הפחתת מורכבות: בגילוי תרופות, מבנים מולקולריים מורכבים מיוצגים בצורה פשוטה, בדומה להפחתה של מודלים גדולים של בינה מלאכותית לצורות קומפקטיות יותר.
- אופטימיזציה ויעילות: גם גילוי תרופות וגם זיקוק מודלים שואפים להשיג תוצאות יעילות וחזקות עם משאבים מוגבלים.
כיצד ניתן ליישם זאת
1. רשתות עצביות גרפיות (GNN) להבנה מבנית
במחקר תרופות, רשתות עצביות גרפיות משמשות לניתוח מבנים מולקולריים. ניתן להשתמש בטכניקות אלו בזיקוק מודלים כדי להבין את המבנה של מודלים גדולים ולחלץ תכונות חיוניות עבור המודל הקטן יותר.
2. העברת למידה וחילוץ תכונות
המודלים מפרויקטים כמו DeepChem או Chemprop משתמשים בהעברת למידה כדי ללמוד ממערכי נתונים קיימים. באופן דומה, בזיקוק, מודל גדול שאומן מראש יכול לשמש כנקודת התחלה שממנה מועברים תכונות חיוניות למודל הקטן יותר.
3. למידה מרובת משימות עבור מודלים רב-תכליתיים
פרויקטים כמו MoleculeNet משתמשים בלמידה מרובת משימות כדי לאמן מודלים שיכולים להתמודד עם מספר משימות בו זמנית. ניתן להשתמש בשיטה זו בזיקוק כדי ליצור מודלים קומפקטיים שעדיין מבצעים פונקציות רב-תכליתיות.
4. טכניקות אופטימיזציה מגילוי תרופות
גישות אופטימיזציה מגילוי תרופות, כגון כוונון עדין של היפרפרמטרים או שימוש באלגוריתמים אבולוציוניים, ניתנות ליישום כדי להפוך מודלים מזוקקים ליעילים יותר.
5. הגדלת נתונים ויצירתם
יצירת נתונים סינתטיים היא המפתח בפרויקטים כמו DeepPurpose. ניתן להשתמש בטכניקות דומות כדי לשפר את תהליך אימון מודל התלמיד בזיקוק, במיוחד כאשר נתונים מוגבלים זמינים.
שלבי יישום מעשיים
- ניתוח מבנה מודל: שימוש ב-GNNs כדי לזהות רכיבים חשובים של מודל המורה.
- בחירת תכונות: חילוץ תכונות קריטיות החיוניות לביצועי המודל.
- עיצובי ארכיטקטורה יעילים: התאמת ארכיטקטורות מודל מגילוי תרופות למבני מודל קומפקטיים יותר.
- הדרכה משותפת: יישום למידה מרובת משימות כדי לאמן את מודל התלמיד במשימות מרובות ובכך לשפר את יכולת ההכללה.
שילוב שיטות מגילוי תרופות אוטומטי בזיקוק מודלים של בינה מלאכותית פותח דרכים חדשות להגברת היעילות ולהפחתת המורכבות. על ידי העברת טכניקות מוכחות, ניתן לפתח מודלים רבי עוצמה וקומפקטיים העונים על הדרישות של יישומי בינה מלאכותית מודרניים. גישה בין-תחומית זו מקדמת חדשנות ומאיצה את ההתקדמות בשני תחומי המחקר.
הרחבה: יישום טכניקות בינה מלאכותית מגילוי תרופות ועד ללימודי תואר ראשון במשפטים (LLM) להפחתת הזיות
התקדמות בבינה מלאכותית חוללה מהפכה הן בגילוי תרופות והן בפיתוח מודלים של שפה גדולה (LLM). שאלה מעניינת היא האם טכניקות מגילוי תרופות אוטומטי יכולות לסייע בהגברת דיוק החיזוי של לימודי תואר ראשון במשפטים ולהפחית הזיות. להלן, נחקור אפשרות זו וננתח האם יישום כזה שימושי והאם טכניקות אלו כבר נמצאות בשימוש בלימודי תואר ראשון במשפטים.
קשר בין בינה מלאכותית לטכנולוגיהטכניקות בכימיה ובלימודי משפטים
1. רשתות עצביות גרפיות (GNN) וניתוח מבני
בגילוי תרופות, רשתות עצביות גרפיות משמשות להבנה וחיזוי המבנים המורכבים של מולקולות. GNN מדגמנים נתונים כגרפים, דבר טבעי בכימיה מכיוון שמולקולות מורכבות מאטומים (צמתים) וקשרים (קצוות).
יישום בלימודי משפטים:
- עצי תחביר כגרפים: בדומה למולקולות, ניתן לייצג משפטים כגרפים, כאשר מילים הן צמתים וקשרים דקדוקיים הם קצוות.
- מידול הקשר משופר: ניתן להשתמש ב-GNN כדי לדגמן טוב יותר את הקשרים בין מילים במשפט, מה שיכול לשפר את ההקשר בלימודי משפטים.
2. אי ודאות והערכת אי ודאות
בגילוי תרופות, הערכת אי ודאות היא קריטית להערכת מהימנות התחזיות.
יישום על תואר שני במשפטים:
- הפחתת הזיות: על ידי שילוב הערכות אי ודאות, תואר שני במשפטים יוכל להעריך טוב יותר את התחזיות שלהם ולהפחית את הסיכוי שיספקו מידע כוזב או הזייתי.
- מדדי ביטחון: יישום מדדים המצביעים על מידת הביטחון של המודל בתשובתו.
3. למידה מרובת משימות ולמידה באמצעות העברה
פרויקטים כמו MoleculeNet משתמשים בלמידה מרובת משימות כדי לאמן מודלים שחוזים תכונות מרובות בו זמנית.
יישום בלימודי משפטים:
- אופטימיזציה סימולטנית של מטרות מרובות: ניתן לאמן לימודי משפטים למיטוב הן של חיזוי המילה הבאה והן של דיוק התוכן.
- העברת ידע בתחום: באמצעות למידה באמצעות העברה, מודלים יכולים להשתמש במומחיות ספציפית מכימיה כדי לבצע תחזיות מדויקות יותר בתחום זה.
4. הגדלת נתונים ויצירת נתונים סינתטיים
בכימיה, נתונים סינתטיים משמשים לשיפור מודלים, במיוחד כאשר הנתונים האמיתיים מוגבלים.
יישום לתואר שני במשפטים:
- הרחבת מערכי נתונים של אימון: יצירת נתוני טקסט נוספים ואיכותיים לשיפור תהליך האימון.
- שיפור יכולת ההכללה: עם נתונים מגוונים יותר, המודל יכול להכליל טוב יותר וליצור פחות הזיות.
האם היישום הגיוני?
העברת טכניקות מגילוי תרופות בסיוע בינה מלאכותית לתואר שני במשפטים הגיונית מבחינה תיאורטית, שכן שני התחומים משתמשים במבני נתונים מורכבים ולמידת מכונה. כמה סיבות לכך הן:
- יסודות מתמטיים נפוצים: שני התחומים משתמשים ברשתות עצביות ובשיטות אופטימיזציה.
- צורך בדיוק ואמינות: הן ברפואה והן בעיבוד מידע, תחזיות מדויקות הן קריטיות.
אתגרים
- סוגי נתונים שונים: נתונים כימיים שונים מבחינה מבנית משפה טבעית.
- מדרגיות: מודלים לתואר שני (LLMs) לרוב גדולים ומורכבים משמעותית ממודלים בכימיה, מה שמקשה על יישום ישיר.
האם טכניקות אלו כבר בשימוש ב-LLMs?
רבות מהטכניקות שהוזכרו כבר בשימוש בצורה כלשהי ב-LLMs משולב:
- הערכת אי ודאות: חלק מהמודלים משתמשים בגישות בייסיאניות או בנשירה מונטה קרלו כדי לדמות אי ודאות.
- מודלים מבוססי גרפים: בעוד ש-GNNs אינם בשימוש ישיר ב-LLMs, ישנם מודלים שלוקחים בחשבון עצי תחביר או גרפי תלות.
- למידה מרובת משימות ולמידה באמצעות העברה: LLMs כמו GPT-4 משתמשים בלמידת העברה וניתן לכוונן אותם למשימות מרובות.
גישות חדשניות פוטנציאליות
למרות הטכניקות הקיימות, קיים פוטנציאל לגישות חדשות:
- מודלים היברידיים: שילוב LLMs עם GNNs למידול הקשר טוב יותר.
- אופטימיזציה בהשראת כימיה: שימוש בשיטות אופטימיזציה מהכימיה לשיפורפיתוח נהלי הכשרה לתואר שני במשפטים.
- מערכי נתונים בין-תחומיים: שילוב נתונים מכימיה כדי להפוך את לימודי התואר השני למדויקים יותר בתחומים מיוחדים.
יישום טכניקות מגילוי תרופות אוטומטי ללימודי תואר שני מציע הזדמנויות מרגשות לשיפור דיוק החיזוי ולהפחתת הזיות. בעוד שכמה שיטות כבר נמצאות בשימוש בלימודי תואר שני, יש מקום לחדשנות נוספת באמצעות גישה בין-תחומית. האתגרים טמונים בעיקר בסוגי הנתונים השונים ובמדרגיות. עם זאת, שיתוף פעולה בין שני תחומים אלה יכול להוביל להתקדמות משמעותית במחקר בינה מלאכותית.
ניסוי מחשבתי קצר: האם זה הגיוני?
כימיה ושפה טבעית נראות שונות במבט ראשון, אך שתיהן מערכות עם כללים ומבנים מורכבים. טכניקות מידול וחיזוי בכימיה יכולות לספק קלט בעל ערך לעיבוד שפה טבעית. חשוב להיות פתוחים לגישות בין-תחומיות, שכן חדשנות נובעת לעתים קרובות בממשקים של תחומים שונים.
שילוב טכניקות בינה מלאכותית מגילוי תרופות ועד לפיתוח תואר שני במשפטים (LLMs) יכול להיות דרך מבטיחה לשיפור נוסף של ביצועי המודלים הללו. על ידי למידה הדדית, שני התחומים יכולים להפיק תועלת הדדית ולפתוח במשותף אופקים חדשים במחקר בינה מלאכותית.
יישום להפחתת הזיות בתואר שני במשפטים באמצעות Hugging Face
להלן, נדגים כיצד ליצור מודל שפה עם הערכת אי-ודאות באמצעות Hugging Face ופייתון כדי להפחית הזיות. אנו משתמשים בטכניקות בהשראת שיטות המשמשות בגילוי תרופות אוטומטי, ובמיוחד הערכת אי-ודאות באמצעות נשירה מונטה קרלו.
דרישות
- Python 3.6 ומעלה
- ספריות מותקנות:
transformerstorchמערכי נתונים
ניתן להתקין את הספריות הנדרשות באמצעות הפקודה הבאה:
pip install transformers torch datasets
יישום קוד
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch.nn.functional as F
import numpy as np

# טען את הטוקנייזר ו model
model_name = 'gpt2'
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)

# אפשר נשירה גם במצב הערכה
def enable_dropout(model):
""מאפשר שכבות נשירה במודל במהלך ההערכה."""
for module in model.modules():
if isinstance(module, torch.nn.Dropout):
module.train()

# פונקציה ליצירה עם הערכת אי ודאות
def generate_with_uncertainty(model, tokenizer, prompt, num_samples=5, max_length=50):
model.eval()
enable_dropout(model)
inputs = tokenizer(prompt, return_tensors='pt')
input_ids = inputs['input_ids']

# תחזיות מרובות להערכת אי ודאות
outputs = []
for _ in range(num_samples):
with torch.no_grad():
output = model.generate(
input_ids=input_ids,
max_length=max_length,
do_sample=True,
top_k=50,
top_p=0.95
)
outputs.append(output)

# פענוח הרצפים שנוצרו
sequences = [tokenizer.decode(output[0], skip_special_tokens=True) עבור פלט בפלט]

# חישוב אי ודאות (אנטרופיה)
probs = []
עבור פלט בפלט:
with torch.no_grad():
logits = model(output)['logits']
prob = F.softmax(logits, dim=-1)
probs.append(prob.cpu().numpy())

# חישוב אנטרופיה ממוצעת
entropies = []
for prob in probs:
entropy = -np.sum(prob * np.log(prob + 1e-8)) / prob.size
entropies.append(entropy)

avg_entropy = np.mean(entropies)
uncertainty = avg_entropy

# בחירת הרצף המופיע בתדירות הגבוהה ביותר מתוך אוספים import Counter
sequence_counts = Counter(sequences)
most_common_sequence = sequence_counts.most_common(1)[0][0]

return {
'generated_text': most_common_sequence,
'uncertainty': uncertainty
}

# דוגמה לשימוש
prompt = "ההשפעה של בינה מלאכותית על הרפואה היא"

result = generate_with_uncertainty(model, tokenizer, prompt)
print("טקסט שנוצר:")
print(result['generated_text'])
print("nאי ודאות משוערת:", result['uncertainty'])
הסבר הקוד
-
טעינת המודל והטוקנייזר: אנו משתמשים במודל GPT-2 שאומן מראש מ-Hugging Face.
tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name) -
אפשר נשירה: אנו משתמשים בפונקציה
enable_dropoutכדי להפעיל את שכבות הנשירה. במהלך ההערכה כדי לאפשר נשירה מונטה קרלו.def enable_dropout(model): for module in model.modules(): if isinstance(module, torch.nn.Dropout): module.train() -
יצירה עם הערכת אי-ודאות: הפונקציה
generate_with_uncertaintyמבצעת מספר תחזיות ומחשבת את אי-הוודאות בהתבסס על האנטרופיה של התפלגויות הפלט.def generate_with_uncertainty(model, tokenizer, prompt, num_samples=5, max_length=50): # הפונקציה מיושמת כפי שמוצג לעיל -
חישוב אי-ודאות: האנטרופיה של התפלגויות ההסתברות מחושבת כדי להעריך את אי-הוודאות. אנטרופיה גבוהה יותר מצביעה על אי-ודאות גבוהה יותר.
-
בחירת הרצף הטוב ביותר: אנו בוחרים את הרצף שנוצר בתדירות הגבוהה ביותר כפלט הסופי מכיוון שהוא סביר להניח שיהיה נכון.
שימוש במאגרי GitHub
לפונקציונליות מורחבת ושיטות מתקדמות, מאגרי GitHub הבאים עשויים להיות מועילים:
-
רשתות שנאים בייסיאניות: שנאים בייסיאניים
- יישום של שנאים עם שיטות בייסיאניות להערכת אי-ודאות.
-
מודלי שפה מועשרים בידע: K-Adapter
- גישה לשילוב ידע עובדתי במודלים של שפה כדי להפחית הזיות.
אפשרויות הרחבה
-
כוונון עדין עם נתונים ספציפיים לתחום: על ידי כוונון עדין של המודל עם מערכי נתונים ספציפיים, ניתן להגדיל את הדיוק.
from datasets import load_dataset # טעינת מערך נתונים ספציפי לתחום dataset = load_dataset('your_dataset') # הכנס קוד כוונון עדין כאן -
שילוב גרפי ידע: שילוב של מסדי נתונים חיצוניים של ידע כגון Wikidata כדי לאמת ולהשלים את הנתונים שנוצרו תוכן.
-
שימוש במודלים גדולים יותר: שימוש במודלים מתקדמים יותר כגון GPT-3 או GPT-4 באמצעות ממשקי API מתאימים לקבלת תוצאות טובות יותר.
סיכום
על ידי יישום הערכת אי-ודאות וטכניקות מגילוי תרופות אוטומטי, אנו יכולים להגדיל את אמינות מודלי השפה ולהפחית הזיות לא רצויות. המימוש שסופק משמש כנקודת התחלה וניתן לפתחו עוד יותר כדי לעמוד בדרישות ספציפיות.
הערה: המימוש המוצג לעיל הוא דוגמה פשוטה. בסביבת ייצור, יש לקחת בחשבון היבטים אחרים כגון יעילות, גמישות ושיקולים אתיים.
מחבר: תומאס פושאדל
זכויות יוצרים ToNEKi Media UG (אחריות מוגבלת)