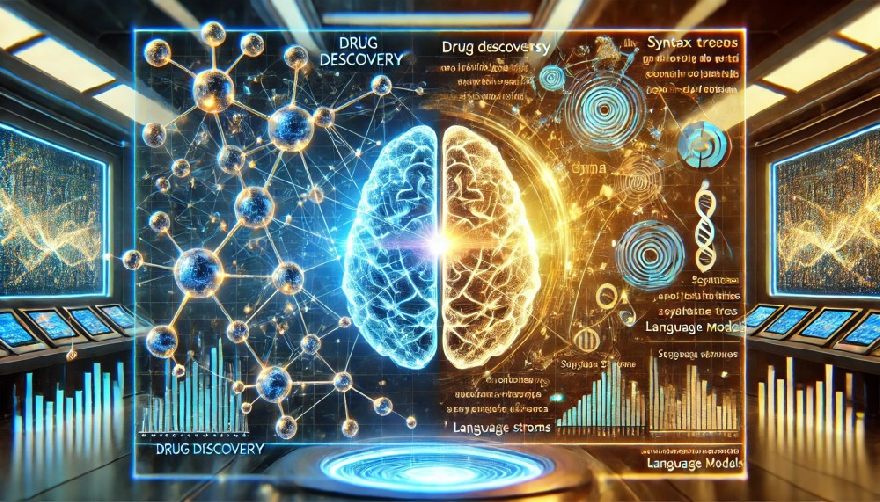
从药物研发到法学硕士 (LLM),AI 技术的应用有助于减少幻觉
2024 年 12 月 5 日
革命性的 GitHub 项目:利用 AI 实现自动化药物研发
人工智能 (AI) 与药物研发的融合正在彻底改变制药行业。GitHub 上的开源项目在其中发挥着至关重要的作用。下面,我们将介绍一些利用 AI 推进自动化药物研发的最具创新性的项目。
DeepChem:化学深度学习的开放平台
DeepChem 是一个领先的开源库,使深度学习能够应用于化学领域。它提供以下领域的工具:
- 分子建模
- 蛋白质结构预测
- 材料科学
DeepChem 凭借其用户友好的界面,使研究人员无需深入的编程知识即可实现复杂的 AI 模型。这加速了新药的发现,并促进了行业的创新。
MoleculeNet:化学领域 AI 的基准测试
MoleculeNet 是一个专为化学研究中的机器学习而设计的综合基准测试系统。它提供:
- 标准化数据集
- 评估指标
- 模型性能比较
通过提供一致的基准,MoleculeNet 促进了不同 AI 模型的比较,从而推动了药物发现的进展。
ATOM 建模管道 (AMPL):加速药物发现
ATOM 建模管道 是 ATOM 联盟的一个项目,旨在通过机器学习加速药物开发。 AMPL 提供:
- 模块化数据准备流程
- 自动化模型训练
- 适用于各种用例的可扩展框架
借助 AMPL,研究人员可以高效地构建复杂模型,从而缩短新药从发现到上市的时间。
Chemprop:基于深度学习的分子特性预测
Chemprop 使用图神经网络来预测分子特性。其特点包括:
- 高预测准确率
- 适应性强的模型架构
- 支持多样化的化学数据集
Chemprop 在多项竞赛中取得了优异成绩,是 AI 辅助化学研究的宝贵工具。
DeepPurpose:通用药物发现工具包
DeepPurpose 是一款用于药物发现的综合深度学习工具包。它提供:
- 集成各种模型和数据集
- 轻松实现预测模型
- 蛋白质-配体相互作用中的应用
DeepPurpose 凭借其多功能性,使研究人员能够快速有效地识别新的候选治疗药物。
OpenChem:专为化学应用打造的深度学习框架
OpenChem 是一个专为化学领域量身定制的深度学习框架。其特点如下:
- 支持分子生成
- 性质预测
- 模型设计的灵活性
OpenChem 促进了化学 AI 新方法的开发,并有助于加速研究进程。
GitHub 上的开源社区正在通过这些项目突破自动化药物发现的界限。AI 与化学的结合为更高效、更精准地开发治疗方案开辟了新的可能性。这些创新有可能持续改变医学的未来。
从药物发现到 AI 模型提炼的 AI 研究模型应用
所使用的 AI 模型和方法提供了创新方法,可以迁移到 AI 模型的提炼中。尽管这两个领域乍看起来有所不同,但它们拥有共同的技术和挑战,从而能够实现有意义的应用。
应用意义
将药物发现领域的研究模型应用于 AI 模型提炼是有意义的,因为:
- 通用方法:这两个领域都利用了先进的机器学习技术,例如深度学习、神经网络和基于图的模型。
- 降低复杂性:在药物发现中,复杂的分子结构以简化形式表示,类似于将大型 AI 模型简化为更紧凑的形式。
- 优化和效率:药物发现和模型提炼都旨在利用有限的资源实现高效且强大的结果。
应用方式
1.用于结构理解的图神经网络 (GNN)
在药物研究中,图神经网络用于分析分子结构。这些技术可用于模型蒸馏,以理解大型模型的结构并为小型模型提取必要的特征。
2. 迁移学习和特征提取
来自DeepChem或Chemprop等项目的模型使用迁移学习从现有数据集中学习。同样,在模型蒸馏中,大型预训练模型可以作为起点,将必要的特征迁移到小型模型。
3. 多任务学习,打造多功能模型
像MoleculeNet这样的项目使用多任务学习来训练能够同时处理多个任务的模型。该方法可用于数据蒸馏,创建仍能执行多种功能的紧凑模型。
4. 药物发现中的优化技术
药物发现中的优化方法,例如微调超参数或使用进化算法,可用于提高蒸馏模型的效率。
5. 数据增强与生成
在DeepPurpose等项目中,生成合成数据是关键。类似的技术可用于改进学生模型在模型提炼中的训练过程,尤其是在数据有限的情况下。
实际实施步骤
- 模型结构分析:使用GNN识别教师模型的重要组成部分。
- 特征选择:提取对模型性能至关重要的关键特征。
- 高效的架构设计:调整药物发现中的模型架构,使其结构更紧凑。
- 联合训练:实施多任务学习,在多个任务上训练学生模型,从而提高泛化能力。
将自动化药物发现中的方法集成到AI模型的提炼中,开辟了提高效率和降低复杂性的新途径。通过迁移成熟的技术,可以开发出功能强大、紧凑的模型,以满足现代AI应用的需求。这种跨学科方法促进了创新,并加速了两个研究领域的进步。
延伸:人工智能技术从药物发现到法学硕士(LLM)的应用,以减少幻觉
人工智能的进步彻底改变了药物发现和大型语言模型 (LLM) 的开发。一个有趣的问题是,自动化药物发现技术是否有助于提高 LLM 的预测准确性并减少幻觉。下文将探讨这种可能性,并分析此类应用是否有效,以及这些技术是否已在 LLM 中得到应用。
人工智能与技术的联系化学和法学硕士 (LLM) 中的技术
1. 图神经网络 (GNN) 和结构分析
在药物研发中,图神经网络用于理解和预测分子的复杂结构。GNN 将数据建模为图,这在化学中很自然,因为分子由原子(节点)和键(边)组成。
在法学硕士 (LLM) 中的应用:
- 语法树作为图:与分子类似,句子可以表示为图,其中单词是节点,语法关系是边。
- 改进的上下文建模:GNN 可用于更好地建模句子中单词之间的关系,从而可以改进法学硕士 (LLM) 中的上下文化。
2. 不确定性与不确定性估计
在药物研发中,不确定性估计对于评估预测的可靠性至关重要。
应用于法学硕士 (LLM):
- 减少幻觉:通过纳入不确定性估计,法学硕士 (LLM) 可以更好地评估自身的预测,并降低提供虚假或幻觉信息的可能性。
- 置信度指标:实施指标来表明模型对其答案的置信度。
3. 多任务学习与迁移学习
像MoleculeNet这样的项目使用多任务学习来训练能够同时预测多种属性的模型。
应用于法学硕士 (LLM):
- 同时优化多个目标:可以训练法学硕士 (LLM) 来优化下一个单词的预测和内容的准确性。
- 领域知识的迁移:通过迁移学习,模型可以利用化学领域的专业知识在该领域做出更精确的预测。
4. 数据增强与合成数据生成
在化学领域,合成数据用于改进模型,尤其是在真实数据有限的情况下。
应用于法学硕士 (LLM):
- 扩展训练数据集:生成更多高质量的文本数据以改进训练过程。
- 提升泛化能力:数据越多样化,模型泛化能力就越强,幻觉越少。
该应用是否有意义?
将人工智能辅助药物研发技术应用于法学硕士 (LLM) 具有理论上的意义,因为这两个领域都利用了复杂的数据结构和机器学习。原因如下:
- 共同的数学基础:这两个领域都使用神经网络和优化方法。
- 对准确性和可靠性的需求:在医学和信息处理领域,精确的预测至关重要。
挑战
- 不同的数据类型:化学数据在结构上与自然语言不同。
- 可扩展性:LLM 通常比化学模型更大、更复杂,这使得直接应用变得困难。
这些技术是否已在 LLM 中使用?
上述许多技术已以某种形式应用于 LLM 集成:
- 不确定性估计:一些模型使用贝叶斯方法或蒙特卡洛 dropout 进行建模不确定性。
- 基于图的模型:虽然 GNN 不直接用于 LLM,但有些模型会考虑语法树或依赖图。
- 多任务和迁移学习:GPT-4 等 LLM 使用迁移学习,可以针对多项任务进行微调。
潜在的创新方法
尽管存在现有技术,但仍有新方法的潜力:
- 混合模型:将 LLM 与 GNN 相结合,以实现更好的上下文建模。
- 受化学启发的优化:利用化学中的优化方法来改进法学硕士 (LLM) 训练程序的改进。
- 跨学科数据集:整合化学数据,使法学硕士 (LLM) 在专业领域更加准确。
从自动化药物发现到法学硕士 (LLM) 的技术应用,为提高预测准确性和减少幻觉提供了激动人心的机会。虽然一些方法已经在法学硕士 (LLM) 中使用,但仍有通过跨学科方法进一步创新的空间。挑战主要在于不同的数据类型和可扩展性。尽管如此,这两个领域的合作可能会带来人工智能研究的重大进展。
简短的思维实验:有意义吗?
化学和自然语言乍一看似乎有所不同,但它们都是具有复杂规则和结构的系统。因此,化学中的建模和预测技术可以为自然语言处理提供有价值的输入。保持跨学科方法的开放态度至关重要,因为创新往往源于不同学科的交叉领域。
将药物研发中的人工智能技术融入法学硕士 (LLM) 的开发中,或许是进一步提升这些模型性能的有效途径。通过相互学习,两个领域可以互惠互利,共同开拓人工智能研究的新视野。
使用 Hugging Face 减少法学硕士 (LLM) 中幻觉的实现
下面,我们将演示如何使用 Hugging Face 和 Python 创建一个带有不确定性估计的语言模型来减少幻觉。我们采用的技术灵感源自自动化药物发现方法,尤其是使用蒙特卡洛dropout进行不确定性估计。
系统要求
- Python 3.6 或更高版本
- 已安装的库:
transformerstorchdatasets
您可以使用以下命令安装所需的库:
pip install transforms torch datasets
代码实现
import torch
from transforms import AutoTokenizer, AutoModelForCausalLM
import torch.nn. functional as F
import numpy as np
# 加载分词器和模型
model_name = 'gpt2'
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
# 即使在评估模式下也启用 dropout
def enable_dropout(model):
""在评估期间启用模型中的 dropout 层。"""
for module in model.modules():
if isinstance(module, torch.nn.Dropout):
module.train()
# 用于生成不确定性估计的函数
def generate_with_uncertainty(model, tokenizer, prompt, num_samples=5, max_length=50):
model.eval()
enable_dropout(model)
inputs = tokenizer(prompt, return_tensors='pt')
input_ids = inputs['input_ids']
# 用于不确定性估计的多个预测
outputs = []
for _ in range(num_samples):
with torch.no_grad():
output = model.generate(
input_ids=input_ids,
max_length=max_length,
do_sample=True,
top_k=50,
top_p=0.95
)
outputs.append(output)
# 解码生成的序列
sequences = [tokenizer.decode(output[0], skip_special_tokens=True) for output in output]
# 计算不确定性(熵)
probs = []
for output in output:
with torch.no_grad():
logits = model(output)['logits']
prob = F.softmax(logits, dim=-1)
probs.append(prob.cpu().numpy())
# 计算平均熵
entropies = []
for prob in probs:
entropy = -np.sum(prob * np.log(prob + 1e-8)) / prob.size
entropies.append(entropy)
avg_entropy = np.mean(entropies)
uncertainty = avg_entropy
# 选择最常出现的序列
from collections import Counter
sequence_counts = Counter(sequences)
most_common_sequence = sequence_counts.most_common(1)[0][0]
return {
'generated_text': most_common_sequence,
'uncertainty': uncertainty
}
# 使用示例
prompt = "人工智能对医学的影响是"
result = generate_with_uncertainty(model, tokenizer, prompt)
print("生成的文本:")
print(result['generated_text'])
print("估计的不确定性:", result['uncertainty'])
代码说明
-
加载模型和 tokenizer:我们使用 Hugging Face 预训练的 GPT-2 模型。
tokenizer = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name) -
启用 dropout:我们使用
enable_dropout函数来启用 dropout 层。在评估过程中启用蒙特卡洛丢弃法。def enable_dropout(model): for module in model.modules(): if isinstance(module, torch.nn.Dropout): module.train() -
基于不确定性估计的生成:函数
generate_with_uncertainty执行多个预测,并根据输出分布的熵计算不确定性。def generate_with_uncertainty(model, tokenizer, prompt, num_samples=5, max_length=50): # 函数实现如上所示 -
不确定性计算:计算概率分布的熵来估计不确定性。熵越高,不确定性越高。
-
选择最佳序列:我们选择生成频率最高的序列作为最终输出,因为它最有可能是正确的。
使用 GitHub 代码库
对于扩展功能和高级方法,以下 GitHub 代码库可能会有所帮助:
扩展可能性
-
使用领域特定数据进行微调:通过使用特定数据集对模型进行微调,可以提高准确率。
from datasets import load_dataset # 加载领域特定数据集 dataset = load_dataset('your_dataset') # 在此处插入微调代码 -
知识图谱集成:集成外部知识数据库(例如 Wikidata)来验证和补充生成的模型内容。
-
使用更强大的模型:通过相应的 API 使用更高级的模型,例如 GPT-3 或 GPT-4,以获得更好的结果。
结论
通过应用不确定性估计和自动化药物发现技术,我们可以提高语言模型的可靠性并减少不必要的幻觉。提供的实现只是一个起点,可以进一步开发以满足特定需求。
注意:上面显示的实现是一个简化的示例。在生产环境中,还应考虑效率、可扩展性和道德方面的因素。
作者:Thomas Poschadel
版权所有 ToNEKi Media UG(有限责任公司)