Auto Learn Cluster Software (ALCS) — kroki w kierunku realizacji rozproszonego przetwarzania AI przez Internet
4 grudnia 2024
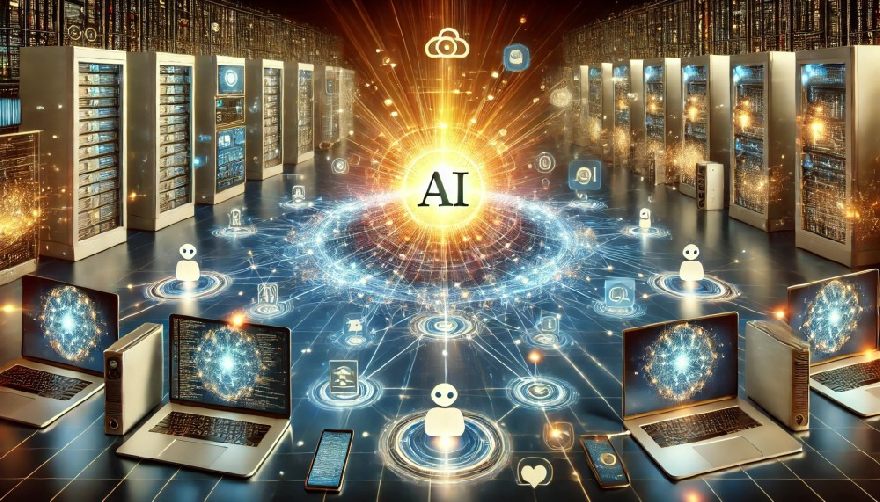
W erze sztucznej inteligencji (AI) zapotrzebowanie na moc obliczeniową rośnie wykładniczo. Auto Learn Cluster Software (ALCS) ma na celu stawienie czoła temu wyzwaniu poprzez wykorzystanie rozproszonego przetwarzania przez Internet. W tym artykule badamy wykonalność tego projektu i przedstawiamy niezbędne kroki do wdrożenia.
Inspiracja istniejącymi systemami rozproszonymi
Zanim zagłębimy się w szczegóły ALCS, warto przyjrzeć się istniejącym rozwiązaniom w dziedzinie rozproszonego przetwarzania:
- SETI@home: Projekt wykorzystujący niewykorzystaną moc obliczeniową milionów komputerów na całym świecie do poszukiwania inteligentnego życia w kosmosie.
- Technologia blockchain: Wykorzystuje zdecentralizowaną sieć do walidacji i rejestrowania transakcji, zapewniając bezpieczeństwo i przejrzystość.
- Oprogramowanie klastrowe (MPI): Interfejs przekazywania wiadomości umożliwia wydajną komunikację w klastrach obliczeniowych o wysokiej wydajności.
Te przykłady pokazują, że rozproszone przetwarzanie jest nie tylko możliwe, ale także skuteczne i skalowalne.
ALCS Komponenty
Front chatbota
Przyjazny dla użytkownika frontend jest kluczowy dla akceptacji dowolnego oprogramowania. Interfejs chatbota pozwala użytkownikom na intuicyjną interakcję z systemem, przesyłanie zapytań i otrzymywanie wyników. Przetwarzanie języka naturalnego obniża barierę wejścia dla użytkowników bez wiedzy technicznej.
Klient obliczeniowy zaplecza
Klient zaplecza jest sercem ALCS. Musi być w stanie działać na różnych platformach sprzętowych:
- ARM: dla urządzeń mobilnych i aplikacji IoT.
- x64: dla aplikacji desktopowych i serwerowych.
- CUDA/Vulkan: dla obliczeń akcelerowanych przez GPU, które są krytyczne w obciążeniach AI.
Ta elastyczność pozwala ALCS na łączenie mocy obliczeniowej z różnych urządzeń.
Przypadek użycia: Rozwój AGI
Ostatecznym celem ALCS jest wsparcie rozwoju sztucznej inteligencji ogólnej (AGI). AGI wymaga ogromnych zasobów obliczeniowych, które można wydajnie zapewnić za pośrednictwem rozproszonej sieci. ALCS może zapewnić badaczom i deweloperom platformę do trenowania i testowania złożonych modeli.
Wykonalność ALCS
Wykonalność techniczna
- Przepustowość sieci: Dzięki ciągłemu ulepszaniu infrastruktury internetowej, wystarczająca przepustowość jest dostępna dla większości użytkowników.
- Skalowalna architektura oprogramowania: Dzięki wykorzystaniu mikrousług i aplikacji kontenerowych oprogramowanie można łatwo skalować.
- Protokoły bezpieczeństwa: Istniejące metody szyfrowania i uwierzytelniania można zintegrować w celu ochrony danych i komunikacji.
Wyzwania
- Heterogeniczny sprzęt: Obsługa różnych platform sprzętowych wymaga rozległych testów i optymalizacji.
- Opóźnienie: Opóźnienia sieciowe mogą mieć wpływ na wydajność, szczególnie w czasie rzeczywistym aplikacje.
- Ochrona danych: Przetwarzanie poufnych danych w rozproszonej sieci wymaga ścisłych środków ochrony danych.
Niezbędne kroki wdrożenia
-
Ocena potrzeb i analiza wymagań
- Identyfikacja grupy docelowej i jej potrzeb.
- Definicja funkcjonalności i celów wydajnościowych.
-
Opracowanie klienta obliczeniowego zaplecza
- Programowanie w języku wieloplatformowym, takim jak Python lub Java.
- Implementacja interfejsów dla CUDA/Vulkan w celu obsługi GPU.
- Integracja protokołów MPI lub podobnych w celu komunikacji między węzły.
-
Rozwój frontendu chatbota
- Wykorzystanie frameworków takich jak TensorFlow lub PyTorch do przetwarzania języka naturalnego.
- Zaprojektowanie intuicyjnego interfejsu użytkownika.
- Połączenie z backendem za pomocą API.
-
Wdrożenie środków bezpieczeństwawziął
- Używanie szyfrowania SSL/TLS do przesyłania danych.
- Wprowadzenie mechanizmów uwierzytelniania, takich jak OAuth 2.0.
- Regularne audyty bezpieczeństwa i aktualizacje.
-
Testowanie i walidacja
- Przeprowadzanie testów jednostkowych i integracyjnych.
- Testy obciążeniowe w celu weryfikacji skalowalności.
- Testy beta z wybranymi użytkownikami w celu zebrania opinii.
-
Wdrożenie i skalowanie
- Używanie platform chmurowych do początkowego wdrożenia.
- Konfigurowanie ciągłej integracji/ciągłego wdrażania (CI/CD) rurociągi.
- Planowanie skalowania poziomego i pionowego w oparciu o liczbę użytkowników.
-
Konserwacja i dalszy rozwój
- Ciągły monitoring systemu w celu wykrywania błędów.
- Regularne aktualizacje w oparciu o opinie użytkowników i postęp technologiczny.
- Rozszerzanie funkcjonalności, np. B. Obsługa dodatkowego sprzętu lub nowych modeli AI.
Wdrożenie ALCS jako oprogramowania do rozproszonego przetwarzania AI przez Internet jest technicznie wykonalne i może wnieść znaczący wkład w rozwój AGI. Łącząc sprawdzone technologie i staranne planowanie, można pokonać wyzwania. Następne kroki obejmują szczegółowe planowanie i krok po kroku implementację opisanych punktów.
Szczegółowy opis oprogramowania zaplecza dla ALCS
Oprogramowanie zaplecza jest sercem oprogramowania klastra Auto Learn (ALCS). Jest ono odpowiedzialne za dystrybucję i zarządzanie obliczeniami AI w sieci heterogenicznych urządzeń, które mogą działać na różnych platformach sprzętowych (ARM, x64, CUDA/Vulkan). W tym artykule wyjaśnimy architekturę, komponenty i możliwe szczegóły implementacji oprogramowania zaplecza. Przedstawimy również istniejące projekty open source na GitHub, które mogą służyć jako podstawa lub inspiracja.
Przegląd architektury
Oprogramowanie zaplecza składa się z następujących głównych komponentów:
- Menedżer zadań: Odpowiada za dzielenie zadań na mniejsze podzadania i przypisywanie ich do dostępnych węzłów.
- Klient węzła: Działa na każdym uczestniczącym urządzeniu i wykonuje przypisane obliczenia.
- Warstwa komunikacji: Umożliwia komunikację między Menedżerem zadań a klientami węzłów.
- Moduł bezpieczeństwa: Zapewnia szyfrowanie i uwierzytelnianie danych i komunikacji.
- Monitor zasobów: Monitoruje wydajność i dostępność węzłów.
Szczegóły implementacji
1. Menedżer zadań
Menedżer zadań może być wdrożony jako scentralizowana lub zdecentralizowana usługa. Zarządza kolejką zadań i dystrybuuje pracę na podstawie możliwości każdego węzła.
Możliwy fragment kodu (Python):
import queue

class TaskManager:
def __init__(self):
self.task_queue = queue.Queue()
self.nodes = []

def add_task(self, task):
self.task_queue.put(task)

def register_node(self, node):
self.nodes.append(node)

def distribute_tasks(self):
while not self.task_queue.empty():
for node in self.nodes:
if node.is_available():
task = self.task_queue.get()
node.assign_task(task)
2. Klient węzła
Klient węzła to lekki program, który działa na węzłach. Komunikuje się z Menedżerem zadań, odbiera zadania i odsyła wyniki.
Możliwy fragment kodu (Python):
import threading
import time

class NodeClient:
def __init__(self, node_id, capabilities):
self.node_id = node_id
self.capabilities = capabilities
self.current_task = None

def is_available(self):
return self.current_task is None

def assign_task(self, task):
self.current_task = task
task_thread = threading.Thread(target=self.execute_task)
task_thread.start()

def execute_task(self):
# Symulowane przetwarzanie zadań
time.sleep(self.current_task['duration'])
self.report_result(self.current_task['task_id'], "Dane wyników")
self.current_task = None

def report_result(self, task_id, result):
# Wysyła wynik z powrotem do Menedżera zadań
pass
3. Warstwa komunikacji
Komunikacja może odbywać się za pośrednictwem interfejsów API RESTful, WebSockets lub protokołów RPC, takich jak gRPC. Aby zapewnić wydajną i bezpieczną komunikację, zalecamy używanie Protobuf z gRPC.
Możliwy fragment kodu (gRPC z Protobuf):
Definicja Protobuf (task.proto):
syntax = "proto3";

service TaskService {

rpc AssignTask (TaskRequest) returns (TaskResponse);

rpc ReportResult (ResultRequest) returns (ResultResponse);
}

message TaskRequest {
string node_id = 1;
}

message TaskResponse {
string task_id = 1;
bytes task_data = 2;
}

messageResultRequest {
string task_id = 1;
bytes result_data = 2;
}

message ResultResponse {
bool success = 1;
}
4. Moduł bezpieczeństwa
Bezpieczeństwo można zapewnić poprzez szyfrowanie SSL/TLS i uwierzytelnianie za pomocą tokena (np. JWT).
Możliwy fragment kodu (uwierzytelnianie za pomocą JWT):
import jwt
import datetime

def generate_token(node_id, secret_key):
payload = {

'node_id': node_id,

'exp': datetime.datetime.utcnow() + datetime.timedelta(hours=1)

}
token = jwt.encode(payload, secret_key, algorithm='HS256')
return token

def verify_token(token, secret_key):
try:
payload = jwt.decode(token, secret_key, algorithms=['HS256'])
return payload['node_id']
except jwt.ExpiredSignatureError:
return None
5. Monitor zasobów
Monitor zasobów zbiera dane o wydajności węzła, takie jak wykorzystanie procesora, wykorzystanie pamięci i przepustowość sieci.
Możliwy fragment kodu (używający psutil):
import psutil

def get_node_resources():
cpu_usage = psutil.cpu_percent()
mem = psutil.virtual_memory()
net = psutil.net_io_counters()
return {
'cpu_usage': cpu_usage,
'memory_available': mem.available,
'network_sent': net.bytes_sent,
'network_recv': net.bytes_recv
}
Wykorzystanie istniejącego oprogramowania Open Source
Istnieje już kilka projektów Open Source, które można dostosować do ALCS lub wykorzystać jako podstawę.
1. BOINC (Berkeley Open Infrastructure for Network Computing)
- GitHub: BOINC
- Opis: BOINC to rozproszona platforma obliczeniowa, która obsługuje projekty takie jak SETI@home. Umożliwia wykorzystanie niewykorzystanej mocy obliczeniowej wolontariuszy z całego świata.
- Adaptowalność: BOINC można zmodyfikować, aby obsługiwał obliczenia specyficzne dla AI i zintegrować z ALCS.
2. MPI4Py
- GitHub: mpi4py
- Opis: MPI4Py zapewnia obsługę MPI dla języka Python i umożliwia programowanie równoległe w klastrach.
- Adaptowalność: Można go używać do implementacji komunikacji i synchronizacji między węzłami w rozproszonym systemie.
3. Ray
- GitHub: Ray
- Opis: Ray to rozproszona platforma obliczeniowa zaprojektowana specjalnie dla aplikacji AI.
- Potencjał dostosowywania: Ray zapewnia wiele wymaganych funkcji i może służyć jako podstawa oprogramowania zaplecza.
4. Horovod
- GitHub: Horovod
- Opis: Horovod to rozproszona struktura szkoleniowa dla TensorFlow, Keras, PyTorch i MXNet.
- Adaptowalność: Można jej używać do ułatwiania rozproszonego szkolenia modeli AI w wielu węzłach.
5. OpenMPI
- Strona internetowa: OpenMPI
- Opis: OpenMPI to wydajna implementacja standardu MPI dla obliczeń równoległych.
- Potencjał dostosowywania: Może być używany do komunikacji zaplecza i synchronizacji w ALCS.
Dalsze aspekty implementacji
Obsługa różnych platform sprzętowych
- ARM i x64: Klient Node powinien być napisany w języku wieloplatformowym, takim jak Python lub Go, aby uzyskać dostęp do różnychdo pracy na różnych architekturach procesorów.
- CUDA/Vulkan: Do obsługi GPU można użyć CUDA (dla GPU NVIDIA) lub Vulkan (niezależny od platformy interfejs API grafiki i obliczeń). W takim przypadku klient Node powinien być napisany w C++ lub innym języku z obsługą GPU.
Przykład integracji CUDA (C++):
#include

__global__ void vector_add(float *A, float *B, float *C, int N) {

int idx = threadIdx.x + blockIdx.x * blockDim.x;
if (idx < N) C[idx] = A[idx] + B[idx];
}

// Wywołanie funkcji jądra
void execute_cuda_task() {
// Przydział pamięci i przygotowanie danych...
vector_add<numBlocks, blockSize>>>(d_A, d_B, d_C, N);
// Pobieranie i czyszczenie wyników...
}
Bezpieczeństwo i prywatność danych
- Szyfrowanie: Wszystkie transfery danych powinny być szyfrowane za pomocą protokołu SSL/TLS.
- Anonimizacja: Dane wrażliwe powinny być anonimizowane lub pseudonimizowane przed przetworzeniem.
- Zgodność: Zgodność z przepisami o ochronie danych, takimi jak RODO.
Tolerancja błędów i odzyskiwanie
- Punkty kontrolne: Przechowywanie stanów pośrednich w celu kontynuowania w przypadku błędów.
- Nadmiarowość: Zadania mogą być wysyłane wielokrotnie do różnych węzłów w celu uniknięcia kompensacji błędów.
Podsumowanie
Rozwój oprogramowanie zaplecza dla ALCS wymaga starannego planowania i rozważenia różnych aspektów technicznych. Poprzez wykorzystanie i adaptację istniejących projektów open source, czas rozwoju może zostać skrócony, a sprawdzone rozwiązania mogą zostać wykorzystane. Ważne kroki obejmują wdrożenie wydajnego menedżera zadań, opracowanie elastycznego klienta węzła i zapewnienie bezpiecznej i niezawodnej komunikacji między komponentami.
Kolejne kroki:
- Prototypowanie: Tworzenie prototypu przy użyciu Ray lub BOINC jako podstawy.
- Testowanie: Przeprowadzanie testów na różnych platformach sprzętowych.
- Optymalizacja: Dostrajanie wydajności i zapewnienie skalowalności.
- Dokumentacja: Szczegółowa dokumentacja dla programistów i użytkowników.
Dzięki konsekwentnemu wdrażaniu tych kroków ALCS może stać się potężną platformą do rozproszonego przetwarzania AI i odegrać ważną rolę w rozwoju AGI.
Data: 4 grudnia 2024 r.
PRAWA AUTORSKIE ToNEKi Media UG (ograniczona odpowiedzialność)
AUTOR: THOMAS JAN POSCHADEL